

Architektura skalowalna to podejście projektowe, w którym system może obsłużyć rosnące obciążenie przez dodawanie kolejnych węzłów (skalowanie poziome) zamiast wyłącznie przez wymianę serwera na mocniejszy (skalowanie pionowe). To cecha wbudowana w projekt od pierwszego dnia, nie łatka doklejana po fakcie. Kilka konsekwencji projektowych wynikają z tej definicji bezpośrednio:
- Skalowanie poziome (horizontal scaling) daje liniowy wzrost wydajności i lepszą odporność na awarie niż dokupowanie mocniejszego sprzętu.
- Minimalizacja koordynacji między komponentami: asynchroniczne wzorce komunikacji i ostateczna spójność tam, gdzie to możliwe, zgodnie z zasadami projektowania skalowalnych systemów.
- Partycjonowanie danych (sharding) i ograniczenia zasobów jako pierwsze kryteria projektowe, nie późniejsza optymalizacja.
- Nadmiarowość i samonaprawa: retry, circuit breaker, health checks, redundancja stref i regionów.
- Mierzalność: KPI takie jak latency, throughput i error rate są niezbędne, by ocenić, czy system rzeczywiście skaluje się zgodnie z oczekiwaniami.
Narzędzia takie jak Kubernetes, AWS i cały ekosystem chmurowy sprawiają, że wdrożenie tych zasad jest dziś dostępne dla każdego zespołu. Pytanie nie brzmi „czy skalować“, lecz „jak zaprojektować to od razu dobrze“.
Kluczowe wnioski
Skalowalna architektura wymaga projektowania pod kątem skalowania poziomego, minimalizacji koordynacji i świadomego zarządzania warstwą danych od pierwszego dnia projektu.
| Punkt | Szczegóły |
|---|---|
| Skalowanie poziome jako fundament | Dodawanie węzłów zamiast mocniejszego sprzętu daje lepszą odporność i niemal liniowy wzrost wydajności. |
| Warstwa danych to wąskie gardło | Sharding, replikacja i cache (Redis) muszą być zaplanowane przed wzrostem wolumenu, nie po. |
| Styl architektoniczny zależy od kontekstu | Monolit sprawdza się przy MVP, mikrousługi i EDA przy dużych systemach z różnymi wymaganiami skalowania per domena. |
| Observability to warunek konieczny | Prometheus, Grafana i Jaeger oraz zdefiniowane SLO/SLI pozwalają kontrolować system w skali. |
| Studio201 projektuje skalowalność od początku | Analiza wymagań, projekt architektury, wdrożenie i audyt OWASP/RODO w jednym procesie. |
Spis treści
- Jakie zasady projektowe decydują o skalowalności systemu?
- Monolit, mikrousługi, EDA, serverless: który styl wybrać?
- Jak skalować warstwę danych: sharding, replikacja, SQL vs NoSQL i cache?
- Jak działa skalowanie infrastruktury: load balancery, autoscaling i Kubernetes?
- Jak zapewnić odporność systemu: monitoring, SLO/SLI i testy chaosowe?
- Jak wdrożyć skalowalną architekturę krok po kroku?
- Jak podejmować trudne decyzje projektowe: CAP, spójność i koszty?
- Jakie narzędzia i technologie są powszechnie używane w Polsce?
- Jak Studio201 podchodzi do projektów skalowalnych?
- Studio201 może zaprojektować i wdrożyć Twoją skalowalną architekturę
- Źródła
Jakie zasady projektowe decydują o skalowalności systemu?
Skalowalność to cecha projektowa, nie operacyjna. Jeśli nie uwzględnisz jej w pierwszych decyzjach architektonicznych, późniejsze próby skalowania będą kosztowne i ryzykowne. Poniżej pięć zasad, które powinny kierować każdym projektem od początku.
1. Minimalizuj koordynację. Każdy punkt synchronizacji między komponentami to potencjalne wąskie gardło. Preferuj asynchroniczne wzorce komunikacji (kolejki, zdarzenia) i projektuj pod kątem ostatecznej spójności (eventual consistency) zamiast natychmiastowej. Synchroniczne wywołania blokujące ograniczają throughput całego systemu do najwolniejszego ogniwa.
2. Projektuj pod kątem skalowania poziomego. Zamiast zakładać, że jeden serwer będzie coraz mocniejszy, zakładaj, że będzie ich coraz więcej. Bezstanowe komponenty aplikacyjne, sesje przechowywane poza procesem (np. w Redis) i idempotentne operacje to fundament tego podejścia.
3. Partycjonuj dane i zasoby od początku. Sharding bazy danych, podział kolejek, izolacja domen to decyzje, które trudno wprowadzić retroaktywnie. Zdefiniuj klucze partycjonowania zanim dane zaczną rosnąć.
4. Buduj nadmiarowość i samonaprawę. Retry z wykładniczym cofaniem (exponential backoff), circuit breaker (np. w Resilience4j lub Polly), health checks i automatyczne przełączanie między strefami dostępności to minimum produkcyjne.
5. Ewoluuj system przez luźne powiązania. Enkapsulacja domeny, wersjonowane API i niezależne cykle wdrożeniowe komponentów pozwalają skalować i zmieniać poszczególne części bez ryzyka kaskadowych awarii. Architektura przedsiębiorstwa (EA) pomaga dopasować te decyzje techniczne do wartości biznesowej i zapobiega nadmiernym inwestycjom infrastrukturalnym.
Porada profesjonalisty: Zanim zaczniesz projektować, zmapuj wzorce obciążenia: które operacje są odczytowe, które zapisowe, gdzie spodziewasz się nagłych skoków ruchu. Ta analiza wskaże, gdzie naprawdę potrzebujesz skalowalności, a gdzie wystarczy prostsza architektura.
Zgodnie z najlepszymi praktykami projektowania architektury IT, modułowość, automatyzacja, monitoring i zarządzanie długiem technicznym są równie ważne jak same wzorce architektoniczne. Bez nich nawet dobrze zaprojektowany system z czasem staje się trudny do utrzymania.
Kolejność priorytetów przy projektowaniu
- Zdefiniuj wymagania dotyczące skalowalności (oczekiwany ruch, wzorce obciążenia, progi latency).
- Wybierz styl architektoniczny dopasowany do tych wymagań.
- Zaprojektuj warstwę danych z uwzględnieniem partycjonowania i replikacji.
- Dobierz mechanizmy komunikacji (synchroniczne vs asynchroniczne).
- Zaplanuj infrastrukturę i autoscaling.
- Zdefiniuj SLO/SLI i narzędzia observability zanim system trafi na produkcję.
Monolit, mikrousługi, EDA, serverless: który styl wybrać?
Wybór stylu architektonicznego to jedna z najważniejszych decyzji projektowych. Każdy wzorzec ma swoje miejsce, a błędny wybór na początku generuje dług techniczny, który rośnie razem z systemem.
| Styl | Skalowalność | Złożoność operacyjna | Szybkość dostarczania | Kiedy stosować |
|---|---|---|---|---|
| Monolit | Ograniczona (pionowa lub pozioma jako całość) | Niska | Wysoka na starcie | MVP, małe zespoły, jednolita domena |
| Mikrousługi | Wysoka (niezależne skalowanie domen) | Wysoka | Średnia | Różne wymagania skalowania per domena, duże zespoły |
| EDA (event-driven) | Bardzo wysoka | Wysoka | Średnia | Wysoki throughput, luźne powiązania, integracje |
| Serverless | Automatyczna, do zera | Niska (infrastruktura) | Wysoka | Nieregularne obciążenie, funkcje pomocnicze |
Monolit to dobry punkt startowy. Jeden deployment, prosta lokalna komunikacja, łatwe debugowanie. Problem pojawia się, gdy różne części systemu mają radykalnie różne wymagania skalowania lub gdy zespół rośnie powyżej kilkunastu osób i zaczyna się wzajemnie blokować.
Mikrousługi rozwiązują problem niezależnego skalowania i niezależnych cykli wdrożeniowych. Każda usługa może być skalowana osobno, wdrażana niezależnie i pisana w innym języku. Cena to złożoność operacyjna: service discovery, rozproszone śledzenie, zarządzanie konfiguracją i sieć staje się częścią domeny problemowej. Mikrousługi najlepiej sprawdzają się tam, gdzie poszczególne domeny biznesowe mają różne wymagania skalowania i niezależne cykle rozwoju.
Architektura sterowana zdarzeniami (EDA) naturalnie łączy się z mikrousługami. Producenci zdarzeń nie wiedzą nic o konsumentach, co daje bardzo luźne powiązania. Apache Kafka lub RabbitMQ jako broker zdarzeń pozwala obsłużyć miliony komunikatów na sekundę i buforować obciążenie w czasie skoków ruchu. Wadą jest trudniejsze debugowanie i konieczność myślenia w kategoriach eventual consistency.
Serverless (np. AWS Lambda, Azure Functions) eliminuje zarządzanie infrastrukturą i skaluje automatycznie do zera. Świetny dla nieregularnych obciążeń, funkcji pomocniczych i przetwarzania wsadowego. Mniej odpowiedni dla długotrwałych operacji i systemów wymagających niskiej latency przy każdym wywołaniu (cold start).
- Komunikacja synchroniczna (REST, gRPC) jest prosta, ale tworzy zależności czasowe między usługami.
- Komunikacja asynchroniczna (kolejki, zdarzenia) zwiększa odporność i throughput kosztem złożoności przepływu danych.
Jak skalować warstwę danych: sharding, replikacja, SQL vs NoSQL i cache?
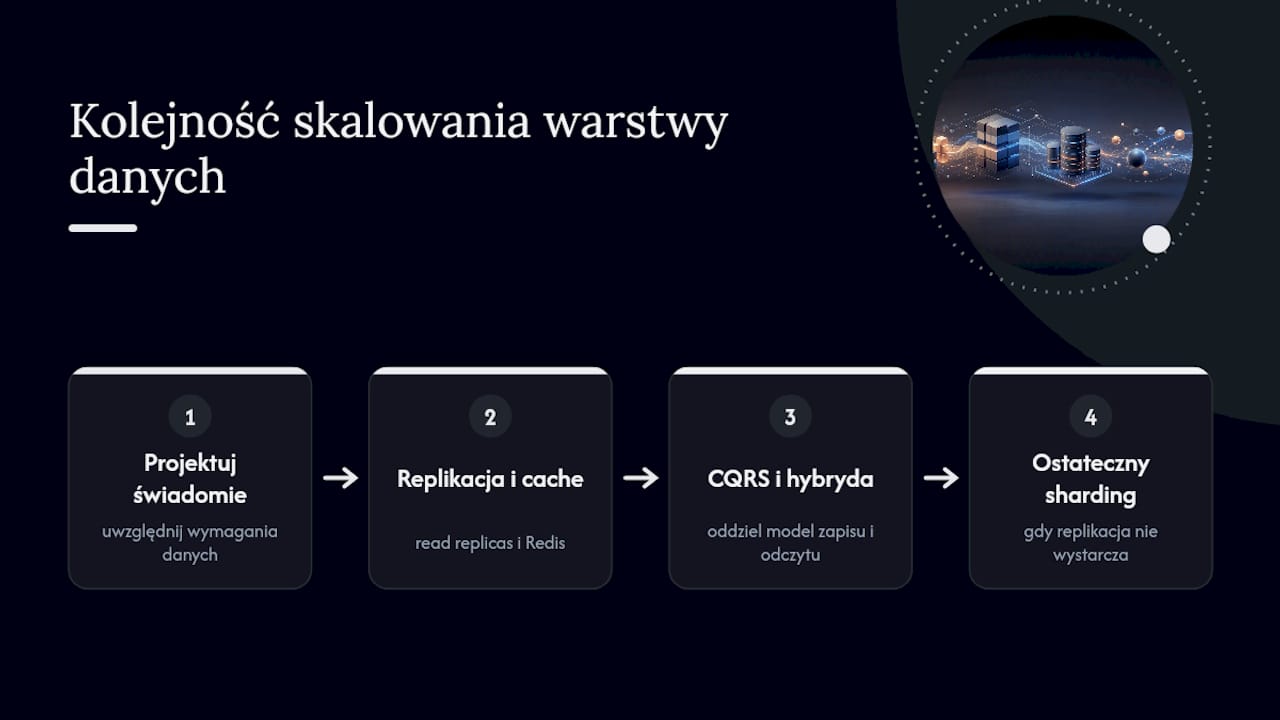
Warstwa danych jest najczęstszym wąskim gardłem w skalowalnych systemach. Aplikację można skalować poziomo w minuty, bazę danych w tygodnie lub miesiące. Dlatego decyzje dotyczące danych wymagają szczególnej uwagi już na etapie projektu.
Sharding (partycjonowanie poziome) polega na podziale danych między wiele węzłów bazy danych według klucza partycjonowania (np. ID użytkownika, region geograficzny). Pozwala rozłożyć zarówno obciążenie zapisu, jak i odczytu. Kluczowa decyzja to wybór klucza shardingu: zły wybór prowadzi do nierównomiernego rozkładu danych (hot shards) i anuluje korzyści. Sharding i replikacja to podstawowe techniki skalowania warstwy danych.
Replikacja (read replicas) kieruje ruch odczytowy do kopii bazy, odciążając węzeł główny. Kompromis wynika z twierdzenia CAP: w systemie rozproszonym nie można jednocześnie zagwarantować spójności (Consistency), dostępności (Availability) i odporności na partycjonowanie sieci (Partition tolerance). Replikacja asynchroniczna daje dostępność, ale repliki mogą być chwilowo nieaktualne.
Twierdzenie CAP nie mówi, że musisz wybrać dwa z trzech atrybutów na zawsze. Mówi, że w momencie awarii sieci musisz wybrać między spójnością a dostępnością. Projektuj świadomie, wiedząc, który kompromis jest akceptowalny dla Twojego przypadku użycia.
SQL vs NoSQL to decyzja zależna od wymagań spójności i wzorców dostępu. PostgreSQL sprawdza się przy złożonych transakcjach, relacjach między danymi i wymaganiach ACID. MongoDB lub Apache Cassandra lepiej radzą sobie z dużymi wolumenami nieustrukturyzowanych danych i wysokim throughputem zapisu. Wybór bazy danych powinien zależeć od wymagań dotyczących spójności i przepustowości; czasem najlepszym podejściem jest hybryda SQL i NoSQL w jednym systemie.
Redis jako warstwa cache redukuje liczbę zapytań do bazy danych o rzędy wielkości. Przechowuj w nim wyniki kosztownych zapytań, dane sesji i często odczytywane konfiguracje. TTL (czas życia klucza) i strategia inwalidacji cache to kluczowe decyzje operacyjne.
CQRS (Command Query Responsibility Segregation) rozdziela modele odczytu i zapisu. Zapisy trafiają do jednego modelu danych, odczyty do zoptymalizowanego widoku (często denormalizowanego). W połączeniu z event sourcingiem daje pełną historię zmian i możliwość odbudowania stanu systemu.
Porada profesjonalisty: Nie sharduj przedwcześnie. Zacznij od replikacji read replicas i cache. Sharding wprowadź dopiero gdy replikacja przestaje wystarczać, bo retroaktywna zmiana klucza shardingu w produkcji to jeden z najtrudniejszych projektów migracyjnych.
Jak działa skalowanie infrastruktury: load balancery, autoscaling i Kubernetes?
Mechanizmy infrastrukturalne przekładają zasady projektowe na rzeczywistą zdolność systemu do obsługi rosnącego ruchu. Bez nich nawet najlepsza architektura aplikacyjna nie skaluje się w praktyce.
Load balancery rozdzielają ruch między instancje aplikacji. Strategie obejmują round-robin, least connections i hash sesji. Nowoczesne load balancery (np. AWS ALB, NGINX, HAProxy) obsługują też terminację TLS, health checks i routing oparty na nagłówkach HTTP.
Autoscaling reaguje na zmieniające się obciążenie bez ręcznej interwencji:
- HPA (Horizontal Pod Autoscaler) w Kubernetes skaluje liczbę podów na podstawie metryk CPU, pamięci lub metryk niestandardowych (np. długość kolejki).
- VPA (Vertical Pod Autoscaler) dostosowuje limity zasobów dla istniejących podów.
- Autoscaling grup instancji w chmurach (AWS Auto Scaling Groups, Azure VMSS) zarządza maszynami wirtualnymi pod spodem.
Metryki triggerujące autoscaling warto rozszerzyć poza CPU: latency percentylowe (p95, p99), długość kolejki komunikatów czy liczba aktywnych połączeń często lepiej odzwierciedlają rzeczywiste obciążenie.
Docker i Kubernetes to dziś fundament skalowalnych deploymentów. Docker pakuje aplikację z jej zależnościami w przenośny kontener. Kubernetes orkiestruje te kontenery: zarządza deploymentami, skalowaniem, service discovery i rolling updates. Chmury publiczne (AWS, Azure, GCP) oferują zarządzane usługi wspierające autoscaling, DBaaS i zarządzane systemy kolejek, co znacząco upraszcza wdrożenie.
CDN i edge (np. Cloudflare, AWS CloudFront) rozpraszają ruch statyczny i dynamiczny bliżej użytkownika końcowego, obniżając latency globalnie i odciążając serwery origin.
Jak kontrolować koszty skalowania?
- Używaj spot instances lub preemptible VMs dla obciążeń tolerujących przerwy (przetwarzanie wsadowe, testy).
- Ustaw limity zasobów w Kubernetes, by uniknąć niekontrolowanego wzrostu kosztów.
- Monitoruj koszt per transakcja, nie tylko łączny rachunek chmurowy.
- Rozważ automatyzację procesów IT, która redukuje koszty operacyjne przez eliminację ręcznych interwencji.
- Regularnie przeglądaj nieużywane zasoby i snapshoty.
Jak zapewnić odporność systemu: monitoring, SLO/SLI i testy chaosowe?
System, który skaluje się bez kontroli operacyjnej, to system, który prędzej czy później wywróci się w nieoczekiwanym momencie. Observability i praktyki odporności to nie opcjonalne dodatki, lecz warunek konieczny produkcyjnej skalowalności.
SLI, SLO, SLA tworzą hierarchię zobowiązań:
- SLI (Service Level Indicator) to mierzalna metryka: dostępność, latency p99, error rate.
- SLO (Service Level Objective) to cel dla SLI: np. „latency p99 poniżej 200 ms przez 99,9% czasu“.
- SLA to umowa z klientem oparta na SLO, z konsekwencjami finansowymi za naruszenie.
Zdefiniuj SLO zanim system trafi na produkcję. Bez nich nie wiesz, kiedy system działa „wystarczająco dobrze“, a alerty stają się subiektywne.
Narzędzia observability tworzą trójkę: metryki, logi, śledzenie. Prometheus, Grafana i Jaeger są powszechnie stosowane i stanowią filar dobrej operacyjności systemów skalowalnych. Prometheus zbiera metryki, Grafana wizualizuje je w dashboardach, Jaeger śledzi przepływ żądania przez wiele mikrousług (distributed tracing). Do zbiorczego logowania sprawdzają się ELK Stack (Elasticsearch, Logstash, Kibana) lub Loki w ekosystemie Grafana.
Runbooki i playbooki to udokumentowane procedury reagowania na konkretne incydenty. Dobry runbook zawiera: opis symptomu, kroki diagnostyczne, akcje naprawcze i eskalację. Bez nich każdy incydent zaczyna się od pytania „co teraz robimy?“.
Testy chaosowe (chaos engineering) weryfikują odporność systemu przez celowe wprowadzanie awarii w kontrolowanych warunkach. Narzędzia takie jak Chaos Monkey (Netflix) lub Litmus Chaos dla Kubernetes pozwalają sprawdzić, czy circuit breakery, retry i failover działają zgodnie z projektem, zanim zrobi to produkcja.
Porada profesjonalisty: Ogranicz liczbę alertów do tych, które wymagają natychmiastowej akcji człowieka. Alert, który nie prowadzi do konkretnego działania, to szum. Zacznij od alertów na SLO burn rate, nie na każde przekroczenie progu CPU.
Checklista observability przed wdrożeniem produkcyjnym:
- Zdefiniowane SLI i SLO dla każdej krytycznej ścieżki.
- Metryki aplikacyjne eksportowane do Prometheusa.
- Dashboardy Grafana dla kluczowych przepływów biznesowych.
- Distributed tracing skonfigurowany (Jaeger lub OpenTelemetry).
- Centralne logowanie z możliwością korelacji logów po trace ID.
- Runbooki dla top 5 scenariuszy awaryjnych.
- Zaplanowany pierwszy test chaosowy w ciągu 30 dni od wdrożenia.
Jak wdrożyć skalowalną architekturę krok po kroku?
Metodologia wdrożeniowa Studio201 opiera się na iteracyjnym podejściu, które minimalizuje ryzyko i pozwala weryfikować założenia architektoniczne na każdym etapie. Poniżej praktyczny plan działania.
-
Discovery i analiza wymagań (tydzień 1–2). Zmapuj wzorce obciążenia: oczekiwany ruch, szczyty, wymagania latency i dostępności. Zidentyfikuj domeny biznesowe i ich granice. Kryterium „go“: udokumentowane wymagania niefunkcjonalne i wstępna mapa zależności.
-
Projektowanie jednostek skali (tydzień 3–4). Wybierz styl architektoniczny, zaprojektuj warstwę danych z kluczami partycjonowania, zdefiniuj interfejsy między komponentami. Kryterium „go“: zaakceptowany diagram architektury i decyzje ADR (Architecture Decision Records).
-
Proof of Concept (tydzień 5–6). Zbuduj minimalny działający system obejmujący krytyczną ścieżkę. Przeprowadź pierwsze testy obciążeniowe. Kryterium „go“: system obsługuje docelowe obciążenie w środowisku testowym bez degradacji powyżej SLO.
-
Iteracyjne wdrożenia (miesiąc 2–4). Wdrażaj kolejne komponenty w krótkich cyklach. Każdy deployment poprzedza code review, testy automatyczne i checklista wdrożeniowa. Przydatna jest tu checklista wdrożenia aplikacji jako punkt odniesienia dla każdego etapu.
-
Operacje i ciągłe doskonalenie (od miesiąca 5). Monitoruj KPI, przeprowadzaj regularne przeglądy architektury, zarządzaj długiem technicznym. Testy chaosowe wchodzą do regularnego kalendarza.
KPI do mierzenia sukcesu architektury
| Metryka | Cel | Narzędzie pomiaru |
|---|---|---|
| Latency p99 | Poniżej progu SLO | Prometheus + Grafana |
| Throughput (req/s) | Zgodny z prognozą ruchu | Prometheus |
| Error rate | bardzo niskie | Prometheus + alerty |
| Koszt per transakcja | Malejący przy wzroście skali | Raporty chmurowe |
| Czas wdrożenia | Poniżej 30 minut | CI/CD pipeline |
Wypowiedź eksperta, Pawła Styperka CEO Studio201: Najczęstszy błąd, który widzimy w projektach, to odkładanie decyzji architektonicznych „na później“. Klienci przychodzą z systemem, który działa przy 100 użytkownikach i chcą go skalować do 100 000. Retroaktywna zmiana architektury kosztuje wielokrotnie więcej niż zaprojektowanie jej dobrze od początku. Dlatego w Studio201 zaczynamy każdy projekt od analizy wzorców obciążenia i decyzji o warstwie danych, zanim napiszemy pierwszą linię kodu.
Porada profesjonalisty: Dokumentuj decyzje architektoniczne w formacie ADR (Architecture Decision Record): kontekst, rozważane opcje, podjęta decyzja i jej uzasadnienie. Za rok Ty lub Twój zespół będziecie wiedzieć, dlaczego system wygląda tak, a nie inaczej.
Jak podejmować trudne decyzje projektowe: CAP, spójność i koszty?
Każda architektura to zbiór świadomych kompromisów. Zrozumienie ich logiki pozwala podejmować decyzje szybciej i z mniejszym ryzykiem żalu.
Twierdzenie CAP mówi, że rozproszony system danych może jednocześnie gwarantować co najwyżej dwa z trzech: spójność ©, dostępność (A) i odporność na partycjonowanie sieci (P). W praktyce partycjonowanie sieci jest nieuniknione, więc wybierasz między CP (spójność kosztem dostępności) a AP (dostępność kosztem chwilowej niespójności). Systemy finansowe zwykle wybierają CP. Systemy społecznościowe i e-commerce często akceptują AP.
Typowe kompromisy w projektowaniu skalowalnych systemów:
- Spójność vs dostępność: replikacja asynchroniczna zwiększa dostępność, ale repliki mogą być chwilowo nieaktualne. Zdecyduj, które operacje wymagają silnej spójności (transakcje finansowe), a które tolerują eventual consistency (liczniki wyświetleń).
- Koszt vs wydajność: cache i CDN redukują latency, ale dodają złożoność i koszt. Autoscaling eliminuje konieczność przewymiarowania, ale wymaga dobrego monitoringu.
- Złożoność operacyjna vs szybkość dostarczania: mikrousługi dają elastyczność, ale wymagają dojrzałego DevOps. Monolit jest prostszy operacyjnie, ale trudniejszy do skalowania selektywnego.
Kiedy wybrać który wzorzec?
- Monolit: nowy produkt, mały zespół (do 5–8 inżynierów), jednolita domena, szybka iteracja ważniejsza niż skalowalność.
- Mikrousługi: różne domeny z różnymi wymaganiami skalowania, duże zespoły, potrzeba niezależnych deploymentów, dojrzały DevOps.
- EDA: wysoki throughput zdarzeń, integracje między systemami, potrzeba luźnych powiązań i buforowania obciążenia.
- Serverless: nieregularne obciążenie, funkcje pomocnicze, prototypowanie, minimalizacja kosztów przy niskim ruchu.
| Scenariusz | Rekomendowany wzorzec | Kluczowy kompromis |
|---|---|---|
| SaaS B2B, duża liczba użytkowników | Monolit modularny lub mikrousługi | Złożoność vs szybkość dostarczania |
| Platforma e-commerce, szczyty ruchu | Mikrousługi + EDA + autoscaling | Koszt vs odporność na szczyty |
| Przetwarzanie zdarzeń IoT | EDA (Kafka) + serverless | Throughput vs latency |
| MVP startupu | Monolit | Szybkość vs skalowalność |
Jakie narzędzia i technologie są powszechnie używane w Polsce?
Ekosystem narzędzi do budowania skalowalnych systemów jest dojrzały i dostępny w Polsce zarówno jako open source, jak i usługi zarządzane w chmurach działających w regionie europejskim.
- Kubernetes: orkiestracja kontenerów, standard de facto dla skalowalnych deploymentów. Dostępny jako usługa zarządzana: EKS (AWS), AKS (Azure), GKE (GCP). Wszystkie trzy dostawcy mają regiony w Europie (Frankfurt, Niderlandy, Warszawa w przypadku Azure), co ułatwia spełnienie wymagań RODO dotyczących lokalizacji danych.
- Docker: konteneryzacja aplikacji, podstawa każdego pipeline’u CI/CD. Używany razem z Kubernetes lub samodzielnie w mniejszych środowiskach.
- PostgreSQL: relacyjna baza danych z rozbudowanymi możliwościami (JSONB, partycjonowanie, replikacja logiczna). Preferowany przy wymaganiach ACID i złożonych transakcjach. Dostępny jako DBaaS w AWS (RDS), Azure (Flexible Server) i GCP (Cloud SQL).
- MongoDB: dokumentowa baza NoSQL, dobra przy nieustrukturyzowanych danych i wysokim throughputem odczytu. Dostępna jako MongoDB Atlas z regionami europejskimi.
- Redis: cache w pamięci, store sesji, kolejka lekkich zadań. Dostępny jako usługa zarządzana (ElastiCache, Azure Cache for Redis). Redukuje obciążenie bazy danych przy odczytach.
- Apache Kafka: rozproszony broker zdarzeń dla wysokiego throughputu (miliony komunikatów na sekundę). Wybór przy EDA, integracjach systemów i przetwarzaniu strumieniowym. Dostępny jako Confluent Cloud lub MSK (AWS).
- RabbitMQ: broker komunikatów dla wzorców kolejkowych i publish/subscribe. Prostszy w konfiguracji niż Kafka, lepszy przy niższym throughputem i bardziej złożonych wzorcach routingu.
- Prometheus: zbieranie metryk w modelu pull. Standard w ekosystemie Kubernetes.
- Grafana: wizualizacja metryk, logów i śladów. Integruje się z Prometheusem, Lokią i Jaegerem.
- Jaeger: distributed tracing, pozwala śledzić przepływ żądania przez wiele mikrousług. Implementuje standard OpenTelemetry.
- AWS, Azure, GCP: chmury publiczne oferują pełen ekosystem usług zarządzanych. Azure ma region w Warszawie, co jest istotne przy wymaganiach dotyczących rezydencji danych w Polsce.
Przy wyborze narzędzi w projektach dla polskich firm warto zwrócić uwagę na dwa aspekty: lokalizację danych (RODO wymaga, by dane osobowe były przetwarzane w UE lub krajach z odpowiednim poziomem ochrony) oraz dostępność wsparcia technicznego w języku polskim lub angielskim. Wszystkie wymienione narzędzia spełniają wymogi RODO przy odpowiedniej konfiguracji i wyborze regionu europejskiego.
Szybkie rekomendacje wyboru:
- Duży throughput zdarzeń, integracje systemów: Apache Kafka.
- Wymagania transakcyjne, złożone relacje: PostgreSQL.
- Nieustrukturyzowane dane, elastyczny schemat: MongoDB.
- Cache i sesje: Redis.
- Orkiestracja kontenerów: Kubernetes (EKS/AKS/GKE).
- Monitoring i alerty: Prometheus + Grafana.
- Distributed tracing: Jaeger z OpenTelemetry.
Jak Studio201 podchodzi do projektów skalowalnych?
Projekty, które do nas trafiają, rzadko zaczynają się od czystej kartki. Częściej to system, który wyrósł z MVP, arkusza Excel lub prototypu AI i teraz potrzebuje architektury, która wytrzyma rzeczywiste obciążenie. Widzimy ten wzorzec regularnie: szybki start, sukces rynkowy, a potem ściana skalowalności.
W Studio201 łączymy praktyki architektoniczne z realistycznym delivery w modelu B2B. Oznacza to, że nie projektujemy architektury w próżni: każda decyzja jest weryfikowana pod kątem kosztów wdrożenia, możliwości zespołu klienta i harmonogramu. Rozwiązania webowe jako klucz do skalowania biznesu to nie slogan, lecz konkretna sekwencja decyzji projektowych, które przekładają się na mierzalne wyniki.
Każde wdrożenie obejmuje audyt bezpieczeństwa zgodny z OWASP Top 10 i weryfikację zgodności z RODO, w tym lokalizację danych i zarządzanie zgodami. Mamy też doświadczenie w migracjach z rozwiązań opartych na Excelu do aplikacji webowych, gdzie kluczowym wyzwaniem jest nie tylko przeniesienie logiki, lecz zaprojektowanie warstwy danych, która wytrzyma wzrost wolumenu bez przebudowy.
Studio201 może zaprojektować i wdrożyć Twoją skalowalną architekturę
Zaprojektowanie skalowalnej architektury od zera to jedno. Zrobienie tego w czasie, budżecie i z gwarancją bezpieczeństwa to drugie. Studio201 dostarcza dedykowane aplikacje webowe i mobilne, w których architektura jest decyzją pierwszego dnia, nie późniejszą naprawą.
Zakres współpracy obejmuje analizę wymagań i wzorców obciążenia, projekt architektury (monolit, mikrousługi, EDA), wdrożenie z pełnym CI/CD, monitoring i autoscaling, audyt bezpieczeństwa OWASP Top 10 oraz weryfikację zgodności z RODO. Pracujemy też z prototypami AI (Lovable, Bolt, Replit) i zamieniamy je w systemy gotowe na produkcję, z dokumentacją, code review i checklistami release’owymi.
Jeśli Twój system rośnie szybciej niż architektura, z której wyrósł, skontaktuj się z nami przez Studio201. Zaczniemy od analizy wzorców obciążenia i wspólnie ocenimy, które decyzje architektoniczne przyniosą największy efekt w Twoim konkretnym przypadku.
Źródła
- Jak zaprojektować skalowalną architekturę systemu: przewodnik krok po kroku
- Najlepsze praktyki w projektowaniu skalowalnej architektury IT
- Architektura mikroserwisów: przewodnik
Masz pytania dotyczące architektury skalowalnej lub chcesz omówić konkretny projekt? Napisz do nas przez Studio201, a wspólnie znajdziemy najlepsze podejście dla Twojego systemu.